
Documentación de ESLE2 BD
Cómo crear tablas, guardar datos y consultarlos con SQL desde el mismo lenguaje SLE2 del curso. Escribí en el buscador del índice para filtrar: se ocultan los apartados que no tengan que ver con lo que buscás.
El entorno está en ESLE2 BD. Los programas se guardan
con extensión .sldb. Si es la primera vez, empezá por
Qué es una base de datos, que explica de qué se trata todo esto
antes de escribir una línea.
Y si preferís aprender haciendo, está el curso de ESLE2 BD: 50 ejercicios que se corrigen solos, de crear una tabla a un informe con subconsultas.
Acá está el lenguaje. La interfaz —qué hace cada botón y cada panel— se explica con capturas en el botón Tutorial de ESLE2 BD.
Qué es una base de datos
Datos guardados de una forma que permite preguntarles cosas.
El problema que resuelve
Un programa puede guardar sus datos en un archivo de texto, y para veinte líneas alcanza. El problema aparece cuando hay que buscar: para responder «¿quién sacó más de 7?» hay que leer el archivo entero y comparar a mano, y para responder «¿cuántos alumnos hay por ciudad?» hay que leerlo entero otra vez.
Una base de datos guarda los mismos datos, pero con una forma declarada —qué hay, de qué tipo, qué no puede faltar, qué no se puede repetir— y con un idioma para preguntarle: SQL. En vez de escribir cómo recorrerlos, se escribe qué se quiere, y el motor se arregla.
// Con un archivo: hay que decir cómo buscar.
desde i = 1 hasta cuantos
{
   si (nota [i] > 7)
   {
      imprimir (nombre [i], "\n")
   }
}

// Con una base: se dice qué se quiere.
SELECCIONAR nombre DE alumnos DONDE nota > 7
Tabla, fila, columna
Una base es un conjunto de tablas. Una tabla es una planilla:
- cada columna es un dato que se guarda de cada cosa —el nombre, la nota— y tiene un tipo (número, texto);
- cada fila es una de esas cosas: un alumno, una venta, una ciudad;
- el orden de las filas no significa nada. Si querés verlas en un
orden, hay que pedirlo con
ORDER BY. Esta es la diferencia más grande con un vector de SL, donde la posición 3 es la posición 3.
Si ya viste registros y vectores en SL, la comparación es casi exacta: una fila es un registro y una tabla es un vector de registros… que además sabe buscarse solo, controla lo que se le mete y no se pierde cuando termina el programa.
La clave primaria: cómo se nombra una fila
Dos alumnos se pueden llamar igual. Entonces «el alumno Ana» no señala a nadie en particular, y sin poder señalar una fila no se la puede modificar ni borrar sin llevarse puesta la otra.
Para eso está la clave primaria: una columna cuyo valor
no se repite nunca y no puede faltar. Casi siempre es un número que no
quiere decir nada —un id—, justamente para que nunca haya que cambiarlo:
una persona se puede cambiar el apellido, pero su número de legajo no.
   CREAR TABLA alumnos (
      id     INTEGER PRIMARY KEY,   -- no se repite y no puede faltar
      nombre TEXT NOT NULL,
      nota   REAL
   )
ESLE2 BD la hace cumplir de verdad: si intentás meter dos filas con el
mismo id, el programa para y lo dice.
Por qué no una sola tabla grande
La primera idea siempre es poner todo junto:
alumnos (nombre, nota, ciudad, departamento_de_la_ciudad)

Ana    9   Asunción      Capital
Beto   6   Encarnación   Itapúa
Cata   8   Asunción      Capital
Dani   7   Asunsión      Capital     ← escrito distinto: ¿es otra ciudad?
Tres problemas, y son siempre los mismos tres:
- se repite. «Asunción / Capital» está escrito dos veces, y con mil alumnos, mil veces;
- se contradice. Alcanza con una letra de más para que existan dos Asunción, y ninguna consulta las va a juntar;
- no se puede decir lo que todavía no pasó. Una ciudad donde no vive ningún alumno no se puede ni anotar: no hay dónde.
La solución es una tabla por cada cosa distinta —una de alumnos y una de ciudades— y una columna que las una. Eso es todo lo que quiere decir «normalizar»: que cada dato esté escrito en un solo lugar.
La clave foránea: cómo se unen dos tablas
En vez de guardar el nombre de la ciudad en cada alumno, se guarda
su clave primaria. Esa columna es una clave foránea, y
se declara con REFERENCES:
   CREAR TABLA ciudades (
      id     INTEGER PRIMARY KEY,
      nombre TEXT NOT NULL,
      depto  TEXT
   )

   CREAR TABLA alumnos (
      id     INTEGER PRIMARY KEY,
      nombre TEXT NOT NULL,
      ciudad INTEGER REFERENCES ciudades (id)
   )
Ahora «Asunción» está escrito una sola vez. Y ESLE2 BD lo hace cumplir:
un ciudad que no existe en ciudades se rechaza. Se admite
NULL, que quiere decir «todavía no se sabe en cuál vive» —y es por eso que
existe el LEFT JOIN—.
La relación se lee siempre en los dos sentidos, y conviene decirla en voz alta: cada alumno vive en una ciudad; en cada ciudad viven muchos alumnos. Eso es una relación uno a muchos, la más común de todas. La clave foránea va siempre del lado de los muchos.
inscripciones (alumno REFERENCES alumnos (id), materia REFERENCES materias (id)).
No hay otra forma, y es la parte que más cuesta al principio.Volver a juntarlas: JOIN
Separar en dos tablas no pierde nada, porque se pueden volver a unir cuando haga falta.
Eso es un JOIN: dos tablas puestas una al lado de la otra, emparejadas por
la columna que las relaciona.
   SELECCIONAR a.nombre, c.nombre, c.depto
   DE alumnos a
   JOIN ciudades c ON a.ciudad = c.id
Guardar el dato una vez y juntarlo al consultar es el intercambio central de las bases de datos: se escribe un poco más al preguntar, a cambio de que nunca haya dos versiones del mismo dato.
Qué mira el motor por vos
| Se declara | Y entonces el motor no deja |
|---|---|
PRIMARY KEY | repetir el valor, ni dejarlo vacío. |
NOT NULL | que falte el dato. |
UNIQUE | que se repita (un correo, un documento). |
DEFAULT valor | —: pone ese valor cuando no se dice ninguno. |
REFERENCES otra (col) | apuntar a una fila que no existe. |
Todo esto se declara una vez, al crear la tabla, y vale para siempre y
para todos los programas que toquen esa base. Es la diferencia de fondo con controlarlo
a mano con si: un control escrito en el programa se olvida en el programa
siguiente.
De acá en adelante
- Cómo se escribe todo esto en ESLE2 BD;
- el diagrama de la base, que dibuja las tablas y sus flechas —y que también se puede dibujar primero y sacar el código después—;
- NULL, que es lo que más cuesta;
- exportar a SQLite, MySQL o PostgreSQL, cuando la base ya tiene que salir de acá.
Qué es ESLE2 BD
El lenguaje de siempre, con las instrucciones de la base adentro.
Las instrucciones se escriben solas
En ESLE2 BD una instrucción de la base es una sentencia más: va sola, sin comillas y sin envolverla en nada. Y va en español, aunque también se entiende en inglés.
inicio
   CREAR TABLA alumnos (id INTEGER PRIMARY KEY, nombre TEXT, nota REAL)

   INSERTAR DENTRO alumnos VALORES (1, 'Ana', 9), (2, 'Beto', 6)

   SELECCIONAR nombre, nota DE alumnos ORDER BY nota DESC
fin
Un SELECCIONAR suelto imprime su tabla y además deja el
resultado listo para recorrer con filas() y dato().
Alrededor está el SL de siempre, sin ningún cambio: las mismas variables, los mismos
ciclos, el mismo si. Lo que hay que aprender en una materia de bases de
datos es SQL, no otra sintaxis.
Dónde empieza y dónde termina
Una instrucción empieza en la primera palabra de un renglón, cuando esa
palabra es un verbo de SQL —CREAR, INSERTAR,
SELECCIONAR, ACTUALIZAR, BORRAR,
ELIMINAR, USAR, o cualquiera de sus formas en inglés— y en ese
mismo renglón viene algo más.
Termina en el ;, o en el renglón donde deja de tener sentido seguirla: uno en
blanco, uno que empieza con una palabra de SL, con }, con un comentario, con
otra instrucción de la base, o con una asignación o una llamada. Los paréntesis abiertos
mandan: mientras haya uno sin cerrar, la instrucción sigue.
   CREAR TABLA alumnos (
      id     INTEGER PRIMARY KEY,
      nombre TEXT NOT NULL,
      nota   REAL
   )

   SELECCIONAR nombre, nota
   DE alumnos
   DONDE nota >= 7
   ORDER BY nota DESC

   imprimir ("listo\n")
Si alguna vez queda la duda de dónde corta, poné un ; al final:
ahí termina, sin discusión.
Meter una variable: @nombre
Adentro de una instrucción, @nombre es el valor de esa variable de SL. ESLE2
BD lo escribe como lo escribiría SQL: los números tal cual y el texto entre comillas
simples, con las comillas de adentro dobladas.
var
   quien : cadena
   i : numerico
inicio
   quien = "O'Higgins"
   i = 7

   INSERTAR DENTRO gente VALORES (@quien, @i)
   SELECCIONAR * DE gente DONDE nombre = @quien
Por eso no hace falta armar la consulta a mano con + y str(),
que es donde se cuelan las comillas mal puestas. Un @ adentro de un texto de
SQL —un correo, por ejemplo— queda como está.
Cuando lo que cambia no es un valor sino la consulta entera (la columna por
la que se ordena, por ejemplo), sigue estando sql(): ver
las subrutinas de la base.
El motor corre en tu navegador
No hay servidor, no hay cuenta que crear y no hace falta conexión: la base vive en la pestaña mientras la tengas abierta. El motor está escrito a mano en JavaScript, igual que el intérprete de SL, así que se puede leer entero y funciona sin conexión.
.sql que después podés
volver a cargar con Base → Importar .sql, o abrir directamente en SQLite, MySQL o
PostgreSQL.Una cadena puede ocupar varias líneas
La otra diferencia con el SL clásico, y está porque una consulta armada como texto se lee mucho mejor en varios renglones:
   consultar ("SELECCIONAR c.nombre, COUNT(*) AS cuantos
                 DE gente g
                 JOIN ciudades c ON g.ciudad = c.id
                GROUP BY c.nombre
                ORDER BY cuantos DESC")
En el IDE clásico esto sigue siendo un error: ahí una cadena empieza y termina en la misma línea.
Las subrutinas de la base
Diez, y con eso alcanza.
| Subrutina | Qué hace |
|---|---|
sql (texto) |
Ejecuta una instrucción armada como texto. Hace falta solo cuando la consulta se arma en el programa; si está escrita tal cual, va suelta y no se usa esto. |
consultar (texto) |
Igual, pero para un SELECT que se va a recorrer sin
imprimirlo. Devuelve la cantidad de filas. Si le pasás algo que no es un
SELECT, avisa. |
filas () | Cuántas filas trajo la última consulta. |
afectadas () |
Cuántas filas tocó el último INSERT, UPDATE o
DELETE. Hace falta porque una instrucción escrita directa es una
sentencia, no una expresión: no se le puede pedir el resultado con un
=. |
columnas () | Cuántas columnas trajo. |
columna (i) | El nombre de la columna i, desde 1. |
dato (fila, col) |
El valor de una celda. col puede ser el número (desde 1) o el nombre
de la columna: dato (i, "nota"). |
hay_dato (fila, col) |
FALSE si ese valor es NULL. Ver
NULL. |
mostrar () |
Imprime el resultado como una tabla alineada. Es lo que hace solo un
SELECCIONAR escrito directo; esto sirve después de
consultar(). |
tablas () · nombre_tabla (i) |
Cuántas tablas hay en la base, y cómo se llama cada una. |
Todos los índices empiezan en 1, igual que los vectores de SL.
Recorrer un resultado
var
   i : numerico
inicio
   CREAR TABLA alumnos (nombre TEXT, nota REAL)
   INSERTAR DENTRO alumnos VALORES ('Ana', 9), ('Beto', 6)

   consultar ("SELECCIONAR nombre, nota DE alumnos ORDER BY nombre")
   desde i = 1 hasta filas ()
   {
      imprimir (dato (i, "nombre"), ": ", dato (i, "nota"), "\n")
   }
fin
Acá se usa consultar() y no un SELECCIONAR suelto
porque el suelto además imprimiría la tabla, y lo que se quiere es solo el ciclo.
El SQL que entiende
El de una primera materia de bases de datos, completo.
Las palabras, en español y en inglés
Cada verbo vale en las dos formas —el motor entiende ambas, y se pueden mezclar en la misma consulta—. Las del español están tomadas de un tutorial de pseudocódigo para MySQL:
| Inglés | Español |
|---|---|
SELECT | SELECCIONAR |
FROM | DE |
WHERE | DONDE |
INSERT INTO | INSERTAR DENTRO |
VALUES | VALORES |
UPDATE | ACTUALIZAR |
SET | CONJUNTO |
DELETE | BORRAR |
CREATE TABLE | CREAR TABLA |
DROP TABLE | ELIMINAR TABLA |
CREATE DATABASE / USE | CREAR BASE DE DATOS / USAR |
IF EXISTS / IF NOT EXISTS | SI EXISTE / SI NO EXISTE |
AS | COMO |
DISTINCT | DISTINTOS |
ORDER BY | ORDENAR POR |
ASC / DESC | ASCENDENTE / DESCENDENTE |
GROUP BY | AGRUPAR POR |
HAVING | TENIENDO |
JOIN | UNIR |
INNER JOIN | INTERIOR UNIR |
LEFT JOIN | IZQUIERDA UNIR |
ON | SEGUN |
LIMIT | LIMITE |
OFFSET | DESPLAZAMIENTO |
AND / OR / NOT | Y / O / NO |
IS NULL / IS NOT NULL | ES NULO / ES NO NULO |
LIKE | COMO_PATRON |
IN | EN |
BETWEEN | ENTRE |
EXISTS | EXISTE |
PRIMARY KEY | CLAVE PRIMARIA |
FOREIGN KEY | CLAVE FORANEA |
REFERENCES | REFERENCIA |
UNIQUE | UNICO |
NOT NULL | NO NULO |
DEFAULT | POR DEFECTO |
NULL | NULO |
SELECCIONAR nombre, nota DE alumnos DONDE nota >= 7
ACTUALIZAR alumnos CONJUNTO nota = nota + 1 DONDE nombre = 'Beto'
BORRAR DE alumnos DONDE nota IS NULL
No queda ninguna palabra que haya que escribir en inglés. El inglés se sigue entendiendo, y los dos idiomas se pueden mezclar en la misma consulta: hace falta para poder volver a cargar un volcado propio, que sale en inglés.
Las palabras de sintaxis se escriben sin tildes, pero con tildes
también andan: SEGUN y SEGÚN son la misma.
Y y O son las dos únicas palabras que
no quedan reservadas, porque una columna llamada y es
moneda corriente (una tabla de puntos, como en
dibujar_pixel()). Se leen como
AND y OR solamente donde no puede haber una columna, así que
las dos cosas conviven:
SELECCIONAR x, y, o DE puntos DONDE y > 0 Y o < 10 ORDENAR POR y
Para el resto —una columna que se llame
nulo o en— están
los corchetes: SELECCIONAR [nulo] DE t.CREAR BASE DE DATOS nombre y USAR nombre
se entienden y no hacen nada más que decirlo: ESLE2 BD ya trabaja con una única base, la
que se ve en el panel La base. Están para que las primeras dos líneas de un
tutorial copiado tal cual no corten el programa justo al empezar.Un texto va entre comillas simples o dobles —las dos formas del
tutorial—: 'Ana' y "Ana" son lo mismo. Para citar un
nombre de tabla o columna que choque con una palabra reservada se usan
acentos graves o corchetes (`select`, [order]); pero un
nombre entre comillas dobles también se entiende directo donde se espera un nombre
—CREAR TABLA "clientes" (...)— porque es justo lo que exportan SQLite y
PostgreSQL, y si no, ni el propio volcado de ESLE2 BD se podría volver a cargar.
Crear y borrar tablas
CREATE TABLE alumnos (
  id     INTEGER PRIMARY KEY,
  nombre TEXT NOT NULL,
  nota   REAL,
  ciudad VARCHAR(30) DEFAULT 'Asunción'
)

CREATE TABLE IF NOT EXISTS alumnos (...)
DROP TABLE alumnos
DROP TABLE IF EXISTS alumnos
CREAR TABLA alumnos (
id ENTERO CLAVE PRIMARIA,
nombre TEXTO NO NULO,
nota REAL,
ciudad CADENA(30) POR DEFECTO 'Asunción'
)
CREAR TABLA SI NO EXISTE alumnos (...)
ELIMINAR TABLA SI EXISTE alumnosLos tipos también tienen su nombre en español. Adentro se guardan con el nombre de siempre, así que el archivo que baja Exportar sigue siendo SQL que SQLite entiende:
| Inglés | Español | Para qué |
|---|---|---|
INTEGER | ENTERO | Números sin coma: un id, una cantidad. |
REAL | REAL | Números con coma: una nota, un precio. |
TEXT | TEXTO | Texto de cualquier largo. |
VARCHAR(n) | CADENA(n) | Texto con un largo máximo. |
CHAR(n) | CARACTER(n) | Texto de largo fijo. |
NUMERIC / DECIMAL(n,d) | NUMERICO / DECIMAL(n,d) | Plata, cuando importan los decimales exactos. |
BOOLEAN | LOGICO | Verdadero o falso, guardado como 1 y 0. |
DATE / TIME / DATETIME | FECHA / HORA / FECHA_HORA | Se guardan como texto: ver Lo que no hace. |
Los modificadores que acepta cada columna son PRIMARY KEY,
NOT NULL, UNIQUE, DEFAULT valor y
REFERENCES. La clave primaria y las columnas UNIQUE se hacen
cumplir de verdad: si intentás meter un valor repetido, el programa para y lo dice.
Relacionar dos tablas: REFERENCES
Una columna puede decir que su valor es la clave primaria de otra tabla. Eso es una clave foránea, y se escribe de las dos formas de siempre:
-- pegada a la columna
CREATE TABLE alumnos (
  id     INTEGER PRIMARY KEY,
  ciudad INTEGER REFERENCES ciudades (id)
)

-- o al final, que es como lo escriben los volcados
CREATE TABLE alumnos (
  id     INTEGER PRIMARY KEY,
  ciudad INTEGER,
  FOREIGN KEY (ciudad) REFERENCES ciudades (id)
)
La columna entre paréntesis se puede omitir —REFERENCES ciudades— y
entonces es la clave primaria de esa tabla, que es lo que se quiere casi siempre.
Se controlan tres cosas:
- al crear la tabla, que la otra exista y que la columna a la que
apunta sea
PRIMARY KEYoUNIQUE. Por eso las tablas se crean de la referida a la que referencia; - al insertar y al modificar, que el valor exista allá.
NULLsí se admite: quiere decir «todavía no se sabe cuál»; - al borrar, no se controla nada. Ver Lo que no hace.
Estas relaciones son las flechas del
diagrama de la base, y también salen en el
.sql que baja Exportar.
Insertar, modificar y borrar
INSERT INTO alumnos VALUES (1, 'Ana', 9)
INSERT INTO alumnos (id, nombre) VALUES (2, 'Beto'), (3, 'Cata')

UPDATE alumnos SET nota = nota + 1 WHERE nota < 7
DELETE FROM alumnos WHERE nota IS NULLUPDATE o un DELETE sin
WHERE tocan todas las filas. No es un error, es lo que
significan, y por eso conviene probarlos antes como un SELECT con el mismo
WHERE.Consultar
SELECT [DISTINCT] columnas
  FROM tabla [alias]
  [JOIN otra [alias] ON condición]
  [WHERE condición]
  [GROUP BY columnas]
  [HAVING condición]
  [ORDER BY columna [ASC|DESC], ...]
[LIMIT n [OFFSET m]]| En la condición | Qué hace |
|---|---|
= <> < <= > >= | Comparar. En SQL el «igual que» es =, con un solo signo. |
Y O NO · AND OR NOT | Combinar condiciones. |
ES NULO · ES NO NULO | Preguntar por el nulo. Ver NULL. |
ENTRE a Y b | Entre dos valores, incluidos los dos. |
EN (a, b, c) | Si es alguno de esos. |
COMO_PATRON 'p%' | Parecido: % es «cualquier cosa» y _ es «una letra». Se llama así, y no COMO a secas, porque COMO ya es el AS que le pone alias a una columna. |
Funciones
| Grupo | En español | En inglés |
|---|---|---|
| De agregación | CONTAR, SUMAR, PROMEDIO,
MINIMO, MAXIMO. Aceptan DISTINTOS:
CONTAR(DISTINTOS ciudad). |
COUNT, SUM, AVG, MIN,
MAX |
| De texto | MAYUSCULAS, MINUSCULAS, LONGITUD,
RECORTAR, SUBCADENA(s, desde, cuantos). Para pegar
textos está ||. |
UPPER, LOWER, LENGTH, TRIM,
SUBSTR |
| De números | ABSOLUTO, REDONDEAR(n [, decimales]) |
ABS, ROUND |
| Para el nulo | PRIMERO_NO_NULO(a, b, ...), SI_NULO(a, b) |
COALESCE, IFNULL |
El diagrama de la base
Verlo, bajarlo, y también dibujarlo primero.
Ver el que ya está: Base → Diagrama de la base
Dibuja lo que hay en la base en este momento: una caja por tabla con sus columnas, la llave 🔑 en la clave primaria, la flecha ↗ en cada clave foránea, y una línea de esa columna a la tabla a la que apunta.
Las tablas se acomodan por capas: arriba las que no apuntan a nadie, debajo las que las señalan. Ese es el mismo orden en el que hay que crearlas, así que el dibujo también cuenta en qué orden va el código.
- Guardar el dibujo baja un
.svg. Es un archivo de imagen que no se pixela y que entra en cualquier informe; - Copiar la descripción copia el mismo diagrama contado en palabras —cada tabla, cada columna, qué es clave y qué apunta a dónde—, que es lo que se pega en un trabajo práctico cuando piden explicarlo.
El dibujo sale del estado real de la base, no del texto del programa: si
una tabla se creó desde SQL a mano o importando un .sql, aparece
igual.
Dibujarlo primero: Base → Dibujar el diagrama…
Al revés: se arma el diagrama y el código sale solo, abajo, mientras se dibuja. Se agregan tablas y columnas, se marca cuál es la clave, y para hacer una relación se elige en la lista a qué columna apunta. Esa elección es la flecha del diagrama: no hay dos cosas que mantener parecidas.
La lista solo ofrece columnas que pueden recibir una flecha —clave primaria o
UNIQUE—, porque apuntar a una columna que se repite no señalaría ninguna
fila en particular. Por eso no se puede dibujar un diagrama que después no compile.
Si algo no cierra —un nombre con espacios, dos columnas iguales, una tabla que apunta a otra que apunta a la primera— se dice debajo del dibujo y el código no se genera hasta que se arregle.
| Botón | Qué hace |
|---|---|
| Traer las de la base | Empieza el diagrama desde las tablas que ya existen, para seguir uno empezado. |
| Guardar el dibujo | Baja el .svg de lo que estás dibujando. |
| Copiar el código | Al portapapeles, para pegarlo donde sea. |
| Escribirlo en el programa | Reemplaza lo que hay en el editor por el programa que crea esas tablas. |
El código sale con las tablas en orden de creación y con las
REFERENCES puestas, así que se ejecuta tal cual:
inicio
   CREAR TABLA ciudades (
      id     INTEGER PRIMARY KEY,
      nombre TEXT NOT NULL
   )

   CREAR TABLA alumnos (
      id     INTEGER PRIMARY KEY,
      nombre TEXT NOT NULL,
      ciudad INTEGER REFERENCES ciudades (id)
   )
finSubconsultas
Una consulta adentro de otra.
Cuando la respuesta necesita otra respuesta primero —«quién compró más que el promedio»— la consulta de adentro se escribe entre paréntesis, donde iría el valor.
| Forma | Qué hace |
|---|---|
(SELECCIONAR …) |
Escalar: vale un valor. Va donde va cualquier valor. |
x EN (SELECCIONAR …) |
De pertenencia: si x es alguno de los que trae. |
EXISTE (SELECCIONAR …) |
De existencia: si trae al menos una fila. No mira los valores. |
DE (SELECCIONAR …) COMO t |
Tabla derivada: el resultado se usa como si fuera una tabla. El alias no es opcional: sin nombre no habría cómo escribir sus columnas. |
-- Las compras por encima del promedio
SELECCIONAR id, monto
DE compras
DONDE monto > (SELECCIONAR PROMEDIO(monto) DE compras)

-- Los clientes que compraron alguna vez
SELECCIONAR nombre DE clientes
DONDE id EN (SELECCIONAR cliente DE compras)

-- Lo mismo, con EXISTE
SELECCIONAR nombre DE clientes COMO c
DONDE EXISTE (SELECCIONAR 1 DE compras COMO p DONDE p.cliente = c.id)

-- Una tabla derivada, unida con una tabla de verdad
SELECCIONAR c.nombre, t.total
DE clientes COMO c
UNIR (SELECCIONAR cliente, SUMAR(monto) COMO total
      DE compras AGRUPAR POR cliente) COMO t
SEGUN t.cliente = c.id
Suelta o correlacionada
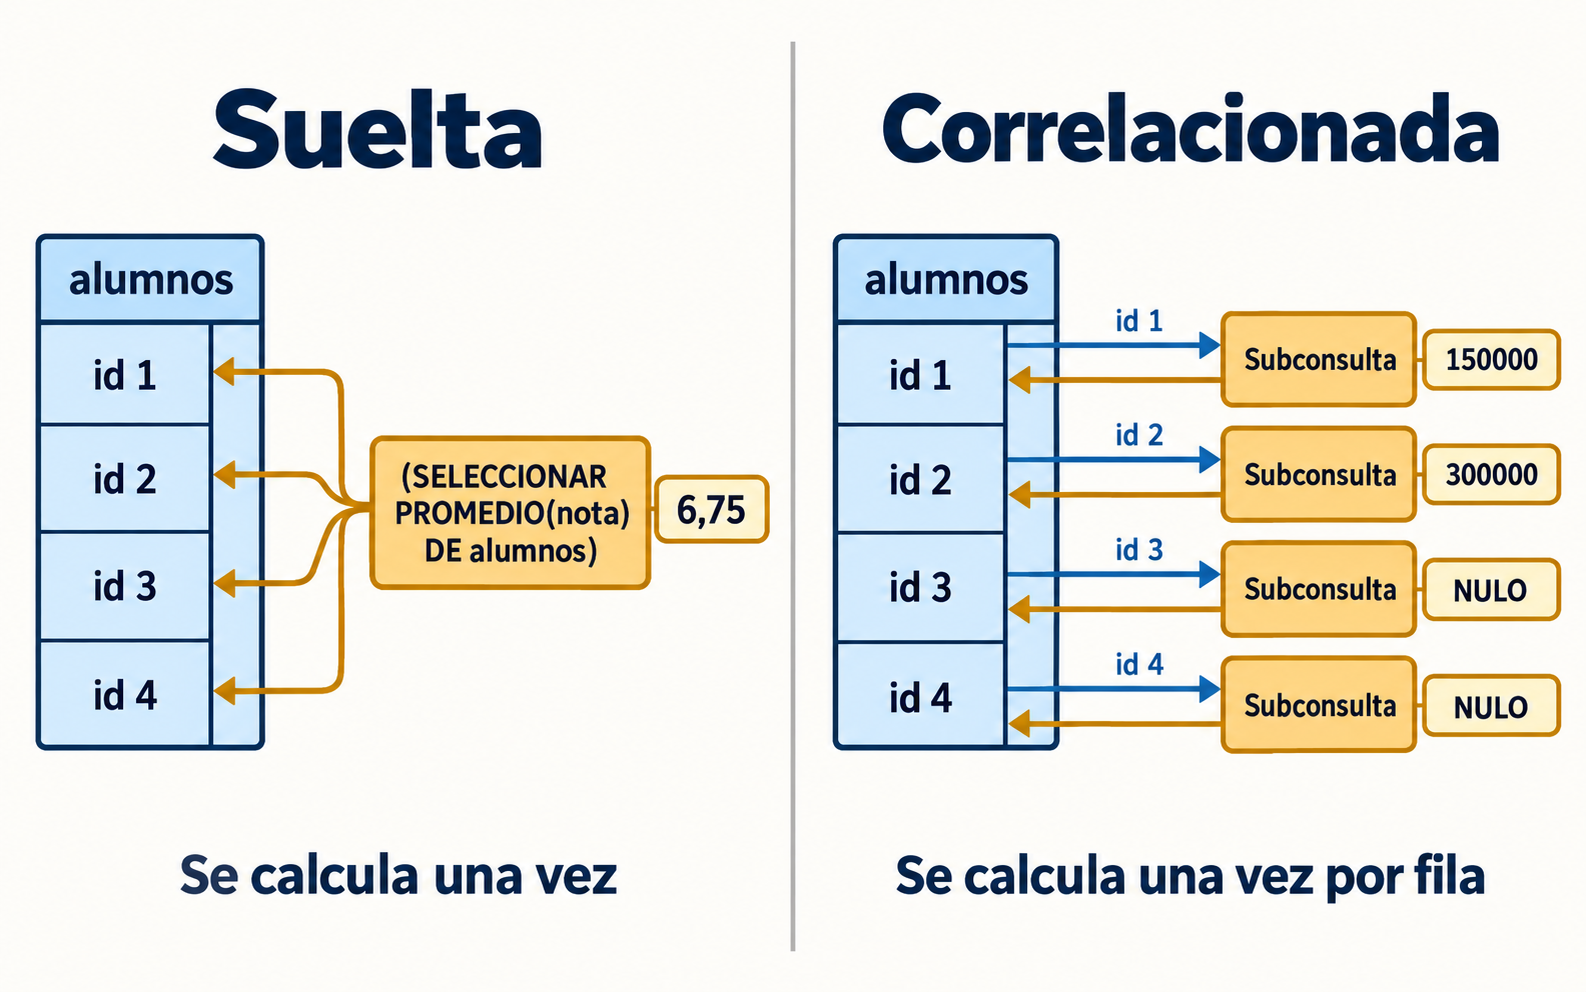
Una subconsulta suelta no nombra nada de la consulta de afuera, así que da lo mismo siempre: el promedio de todas las compras es uno solo.
Una correlacionada sí la nombra —el c.id del ejemplo del
EXISTE— y entonces se calcula una vez por cada fila de afuera, con
el valor de esa fila. Es lo que la hace poderosa y también lo que la hace cara: con mil
clientes son mil consultas.
Una escalar trae un valor, no el primero que aparezca
Si la consulta de adentro trae más de una fila, el motor para. Podría quedarse con la primera, pero las filas de una tabla no tienen orden: «la primera» no quiere decir nada, y devolver una al azar sería inventar la respuesta.
| La de adentro trae | El valor es |
|---|---|
| Ninguna fila | NULO — «no se sabe» es exactamente lo que pasó. |
| Una fila | Ese valor. |
| Más de una | Error. Agregá un filtro, o usá MINIMO() o MAXIMO(). |
| Más de una columna | Error, aunque venga vacía. |
NO EN y el nulo: la trampa clásica
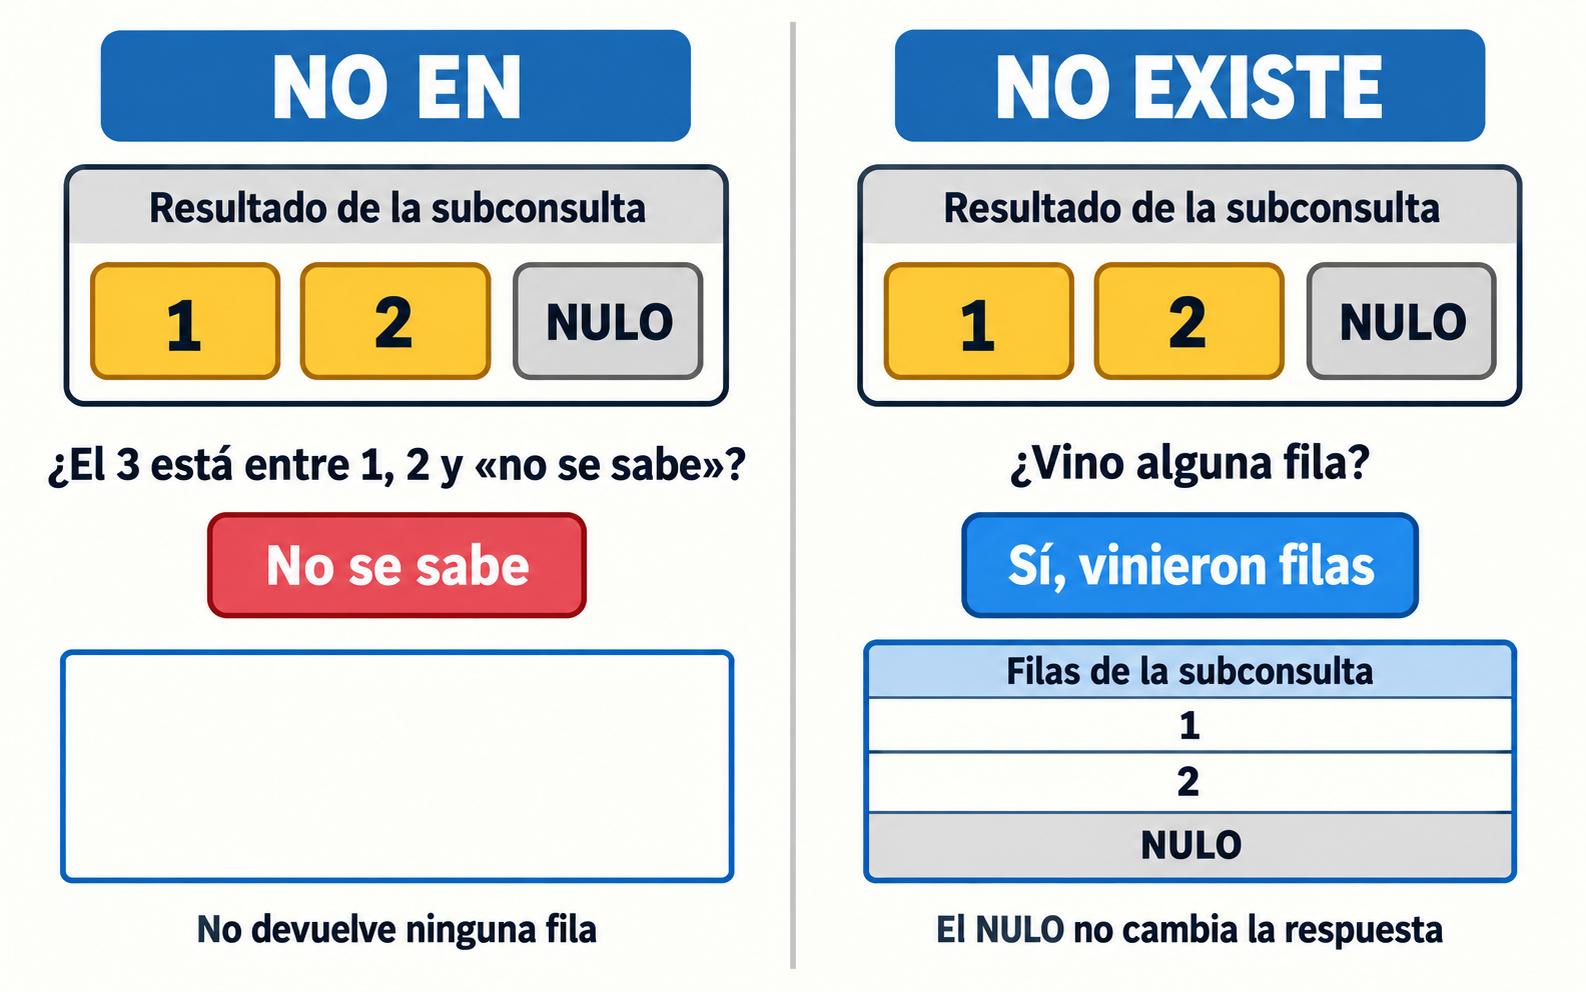
NO EN compara valores, así que un NULO la vuelve desconocida; NO EXISTE solo pregunta si hay filas, y el nulo no le cambia nada.Esta es la que más cuesta de todo SQL, y no es un capricho del motor: sale sola de lo que significa NULO.
-- Los clientes que NO compraron… y no devuelve ninguno:
SELECCIONAR nombre DE clientes
DONDE id NO EN (SELECCIONAR cliente DE compras)
Si en compras hay una fila con el cliente en NULO, la
pregunta «¿el 3 está entre 1, 2 y no se sabe?» no tiene respuesta: puede que
ese que no se sabe sea el 3. La respuesta es desconocido, y una fila con
condición desconocida no entra.
NO EXISTE no tiene el problema, porque no compara valores: solo pregunta
si hay filas.
-- Así sí:
SELECCIONAR nombre DE clientes COMO c
DONDE NO EXISTE (SELECCIONAR 1 DE compras COMO p DONDE p.cliente = c.id)
Hasta dónde se puede anidar
32 niveles. Pasado eso el motor para y lo dice, y con razón: a esa altura la consulta ya no la lee nadie.
Anidar no esquiva los topes: el presupuesto es de la instrucción entera y lo comparten todas las subconsultas. Una correlacionada sobre una tabla grande se para por ahí, no por el anidamiento.
NULL: lo que más cuesta
No es cero, no es vacío, y no es igual a sí mismo.
NULL quiere decir «no se sabe». Y de ahí sale todo lo
demás: si no sabés la edad de Beto, tampoco podés decir si es igual a la de Ana. Por eso
NULL = NULL no da verdadero: da desconocido, y una
fila con condición desconocida no entra en el resultado.
-- No encuentra a nadie, ni siquiera a los que tienen la edad en NULL:
SELECT nombre FROM gente WHERE edad = NULL

-- Así sí:
SELECT nombre FROM gente WHERE edad IS NULL
Lo mismo con las cuentas: edad + 1 sobre un NULL da
NULL, no 1.
Los agregados lo ignoran
AVG(edad) promedia solo las edades que hay: no cuenta los nulos como cero,
que daría un promedio más bajo y equivocado. Por eso COUNT(edad) y
COUNT(*) pueden dar distinto, y esa diferencia es exactamente la cantidad de
nulos.
Desde el programa: hay_dato()
En SL no existe el nulo: una variable de tipo cadena siempre tiene un
texto, aunque sea vacío. Entonces dato() devuelve la cadena vacía cuando el
valor era NULL… y eso se confundiría con un texto vacío de verdad. Para
distinguirlos está hay_dato():
   si (hay_dato (i, "edad"))
   {
      imprimir (dato (i, "edad"), "\n")
   sino
      imprimir ("no se sabe\n")
   }
En la tabla que dibuja mostrar(), y en el panel de resultados
de la página, un NULL se ve escrito como NULL en gris: si se viera
como un hueco no se distinguiría de una cadena vacía.
El entorno
Qué hay en la pantalla de ESLE2 BD.
- El programa. El editor de siempre, con los mismos colores y los mismos
atajos. Los programas se guardan como
.sldb. - El autocompletado (Ctrl + Espacio, o solo escribiendo) acá sabe además de SQL: las palabras en español y en inglés, las subrutinas de la base, y —lo que más sirve— los nombres de las tablas y de las columnas que hay en la base en este momento, con su tipo y diciendo cuál es la clave y cuál apunta a otra tabla. Esos son justo los nombres que no se pueden adivinar.
- La base. Las tablas que hay, con sus columnas, su tipo y la clave primaria
marcada. Se actualiza sola después de cada ejecución. Ver las filas muestra
el contenido sin que tengas que escribir el
SELECT. - Salida. Lo que imprime el programa y el resultado de cada consulta, dibujado como tabla.
- SQL a mano. Para probar una consulta sin tocar el programa (Ctrl + Enter). Es el mismo motor y la misma base.
- Base → Datos de ejemplo arma tres tablas —ciudades, alumnos y materias— con
datos para practicar consultas sin escribir los
INSERT. - Base → Diagrama de la base y Base → Dibujar el diagrama…: ver el diagrama entidad-relación y bajarlo, o dibujarlo y que salga el código. Están explicados en El diagrama de la base.
- La pestaña Curso: 50 ejercicios por nivel. Se corrigen mirando
la base que quedó, no lo que el programa imprime: cada ejercicio
corre contra una base nueva y después se revisa qué tablas hay, qué filas tienen y
qué trajo tu consulta. Por eso no alcanza con escribir la respuesta con
imprimir(). Tu avance se guarda en una cookie de este navegador. - Base → Vaciar borra todo y empieza de nuevo. La base no se vacía al ejecutar: si se vaciara, no podrías escribir un programa que consulta lo que dejó otro, que es como se trabaja de verdad.
Exportar la base
A SQLite, MySQL y PostgreSQL.
El menú Exportar baja un archivo .sql con el
CREATE TABLE de cada tabla y los INSERT de sus filas, escrito
como lo escribe cada motor. Se abre en el motor de verdad y también se puede volver a
cargar acá con Base → Importar .sql.
| Motor | Para cargarlo |
|---|---|
| SQLite | sqlite3 base.db < base.sqlite.sql |
| MySQL | mysql -u usuario -p base < base.mysql.sql |
| PostgreSQL | psql -d base -f base.postgres.sql |
Los tres no escriben igual, y eso se ve
| Diferencia | SQLite | MySQL | PostgreSQL |
|---|---|---|---|
| Proteger un nombre | "tabla" | `tabla` | "tabla" |
Un DECIMAL(10,2) | REAL | DECIMAL(10,2) | NUMERIC(10,2) |
Un TEXT que es clave | TEXT | VARCHAR(255) | TEXT |
| La barra invertida en un texto | tal cual | hay que escaparla | tal cual |
Sale un archivo de texto y no un .sqlite binario a propósito:
un archivo de texto se lee, se corrige y se entrega en un trabajo práctico.
Lo que no hace
Dicho de frente, para que no sorprenda.
Hasta dónde llega
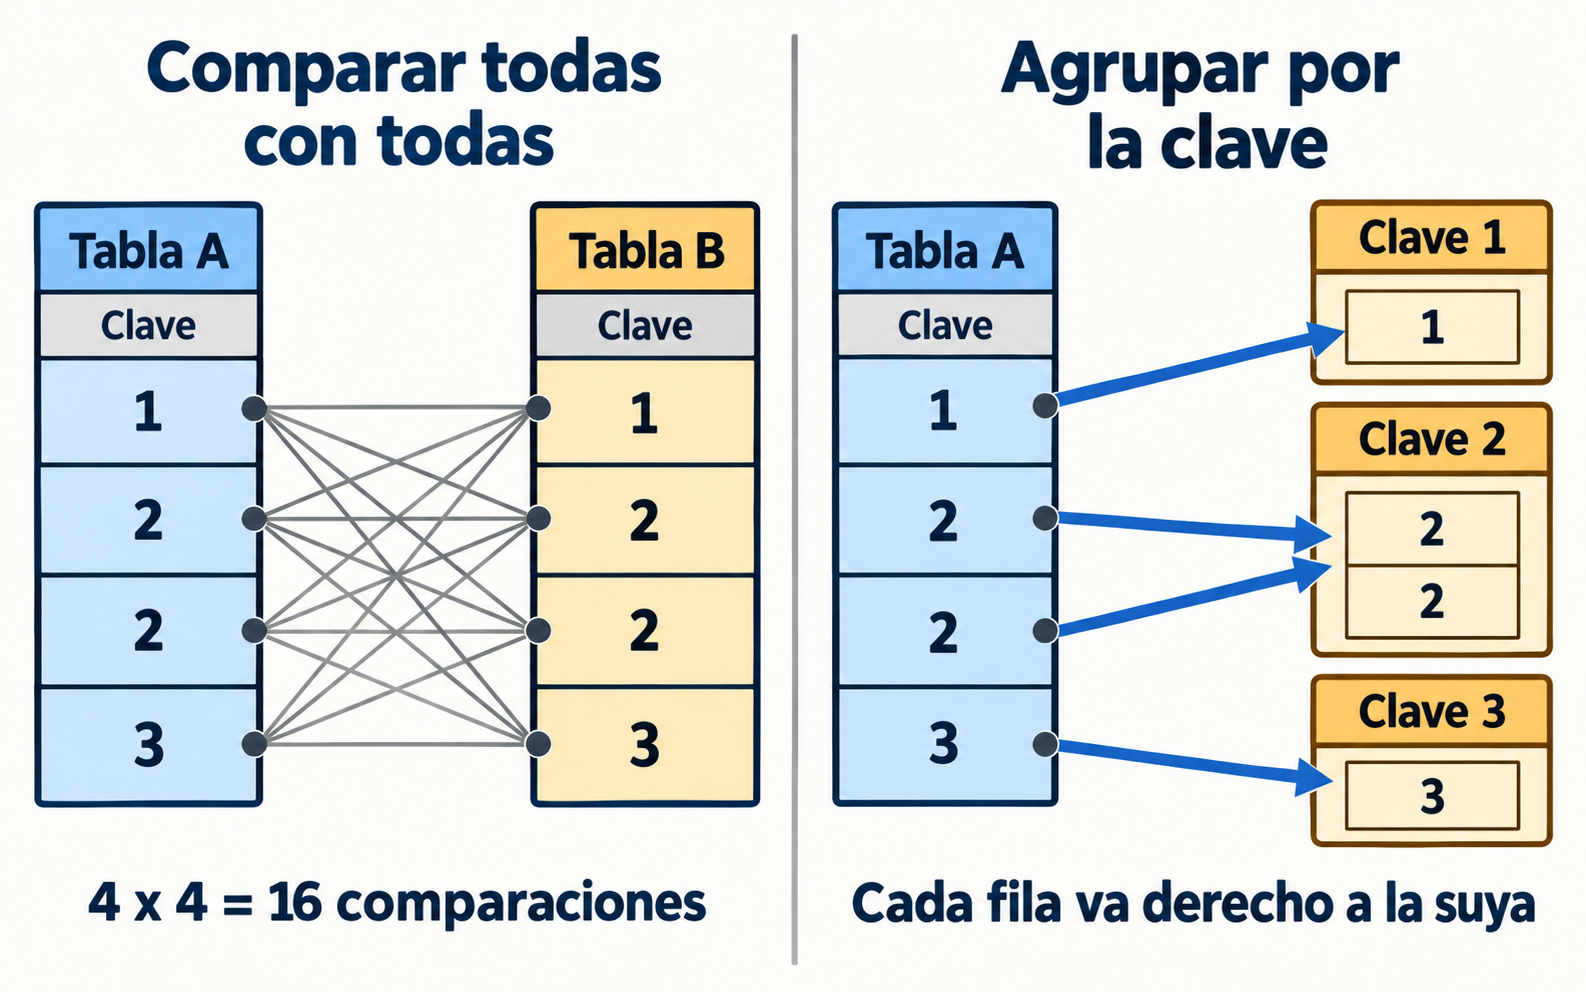
UNIR entre dos tablas grandes termina: cuando el SEGUN es una igualdad, las filas se agrupan por esa clave y cada una va derecho a las que le tocan, en vez de compararse con todas.La base vive en la pestaña, así que tiene la memoria que tiene una pestaña. Cada instrucción tiene un presupuesto, y la que se pasa para y lo dice: nunca devuelve un resultado cortado que parezca completo.
| Tope | Cuánto |
|---|---|
| Filas en una tabla | 100.000 |
| Filas en toda la base | 500.000 |
| Filas que puede armar una consulta | 100.000 |
| Tiempo de una instrucción | 5 segundos |
El tope de las filas de una consulta se mira antes del
LIMITE: un UNIR sin condición entre dos tablas de mil filas
arma un millón de filas aunque después se pidan diez, y esa memoria ya se gastó. Por
eso el LIMITE no sirve para esquivar el tope; lo que sirve es filtrar.
VALORES de un INSERTAR repite la clave, no entra
ninguno de los tres; si un ACTUALIZAR falla en la fila del medio, no cambia
ninguna. La base queda exactamente como estaba.Mientras una instrucción corre, la página se queda quieta hasta que termina o hasta que se le acaban los cinco segundos. Es la contra de que el motor corra en la misma pestaña que el editor.
El motor cubre el SQL de una primera materia. Lo que no está:
UNION, las consultas con nombre (WITH), las funciones de ventana yLATERAL. Sí están las subconsultas;ON DELETE CASCADEyON DELETE RESTRICT. Las claves foráneas se controlan al insertar y al modificar, pero al borrar una fila no se mira quién la señalaba: para eso habría que decir cuál de las dos cosas hacer —borrar también lo que apunta, o negarse—, y elegir una por nuestra cuenta sería hacer algo que el programa no pidió;- claves primarias y foráneas de varias columnas: acá son siempre de una sola;
- índices, vistas, disparadores, transacciones con
ROLLBACK; RIGHT JOINyFULL JOIN(sí estánJOINyLEFT JOIN);- fechas como tipo propio: se guardan como texto
'2026-09-02', que ordena bien porque el año va primero.
Cuando algo de esto haga falta, el camino es exportar la base y seguir en SQLite, MySQL o PostgreSQL, que es justamente para lo que está el menú Exportar.